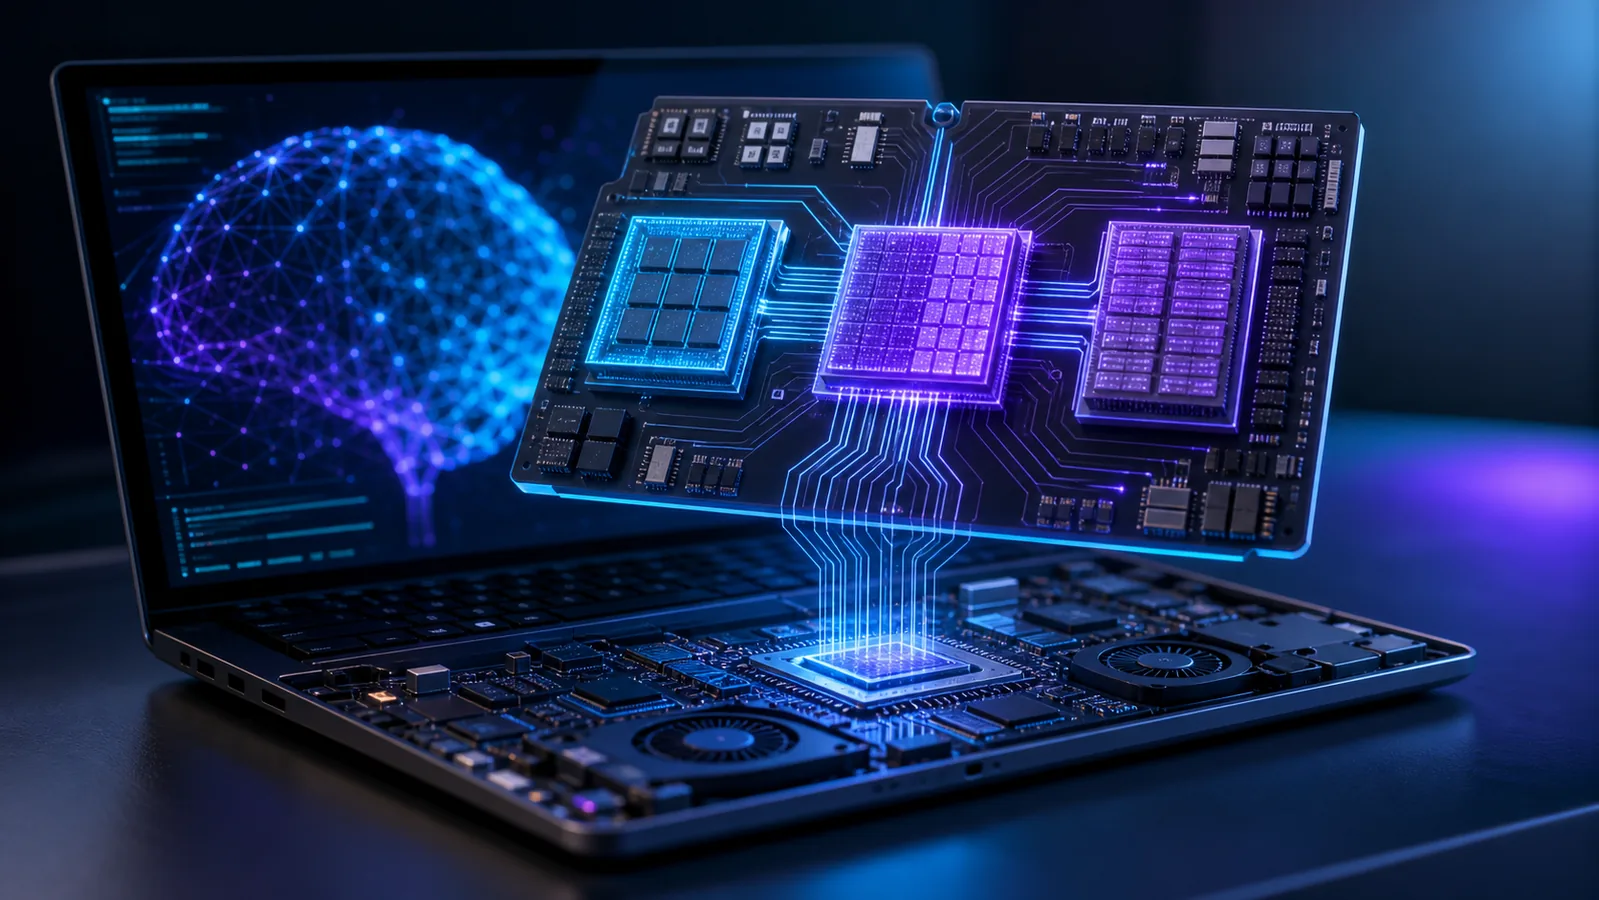
Durante décadas, CPU e GPU dividiram a maior parte do trabalho em um computador pessoal. A popularização da inteligência artificial local acrescentou um terceiro componente: a NPU, unidade de processamento neural projetada para executar redes neurais com baixo consumo de energia.
O que é uma NPU?
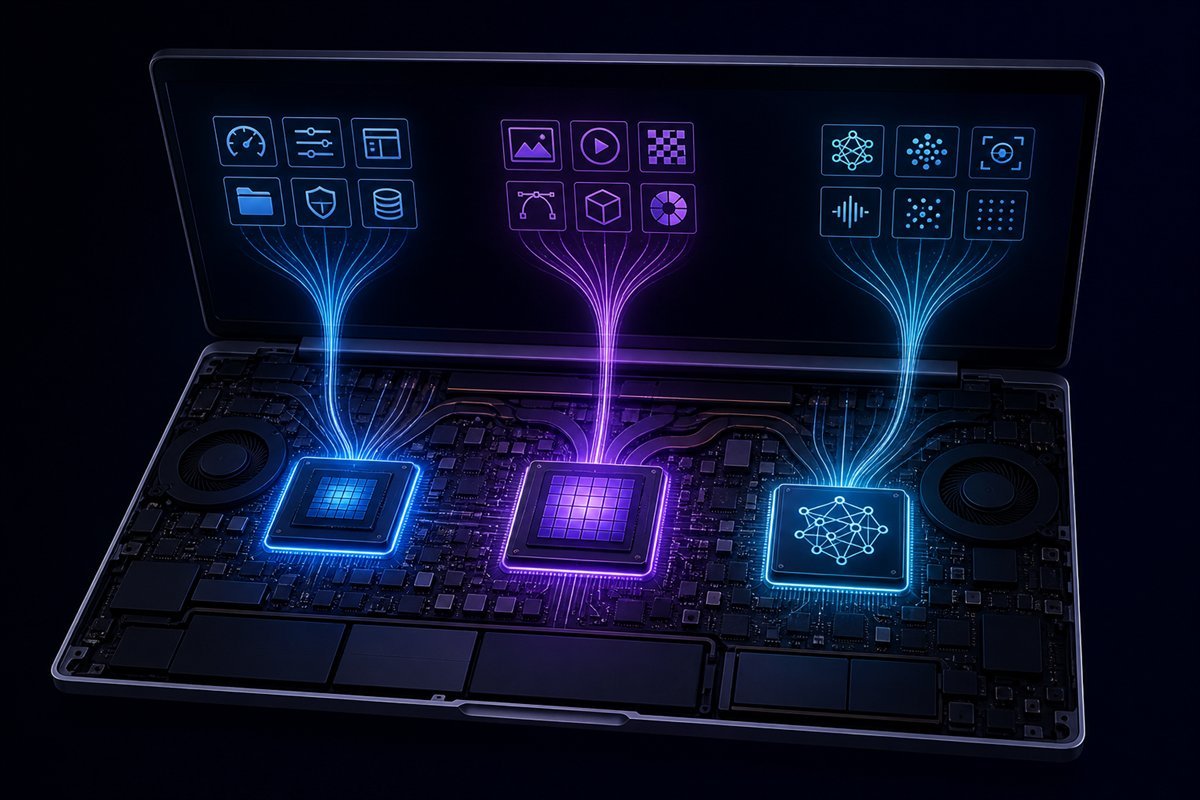
NPU é um acelerador especializado em operações matemáticas recorrentes em modelos de aprendizado de máquina, sobretudo multiplicações de matrizes e tensores. Ela não substitui o processador central nem a placa gráfica. O sistema distribui tarefas conforme latência, eficiência, memória e compatibilidade.
CPU, GPU e NPU: qual é a diferença?
| Componente | Ponto forte | Uso típico |
|---|---|---|
| CPU | Flexibilidade e controle | Sistema, aplicativos e tarefas variadas |
| GPU | Paralelismo e alta capacidade | Gráficos, criação e modelos pesados |
| NPU | IA eficiente e contínua | Efeitos de câmera, áudio, visão e modelos locais compatíveis |
Uma GPU dedicada costuma entregar mais desempenho bruto, mas consome mais energia. A NPU busca realizar uma classe estreita de operações de maneira eficiente, algo especialmente valioso em notebooks.
O que significa TOPS?
Fabricantes divulgam capacidade de NPU em TOPS, trilhões de operações por segundo. O número ajuda a situar uma geração de hardware, mas não compara sozinho a velocidade real. Precisão numérica, largura de banda de memória, software, tamanho do modelo e tempo de transferência de dados afetam o resultado. TOPS não equivale automaticamente a “mais inteligência”.
Quais tarefas podem usar a NPU?
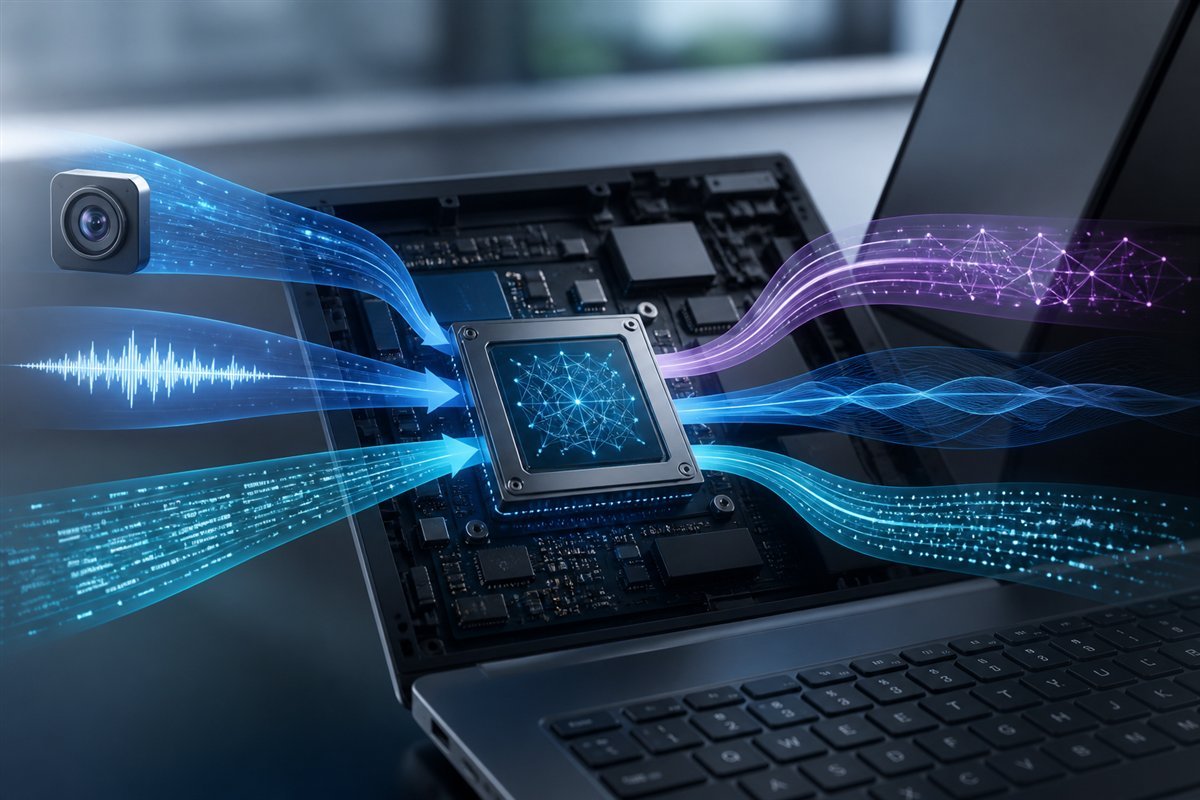
- desfoque de fundo e enquadramento automático em videochamadas;
- redução de ruído e separação de voz;
- reconhecimento de imagem e texto;
- tradução, transcrição e legendas quando o aplicativo oferece execução local;
- modelos generativos compactos e recursos de assistência;
- processamento contínuo com menor impacto na bateria.
A existência da NPU não garante que todo programa a utilizará. O aplicativo precisa empregar uma API ou runtime compatível, e o modelo deve estar preparado para aquele acelerador.
Por que executar IA no próprio computador?
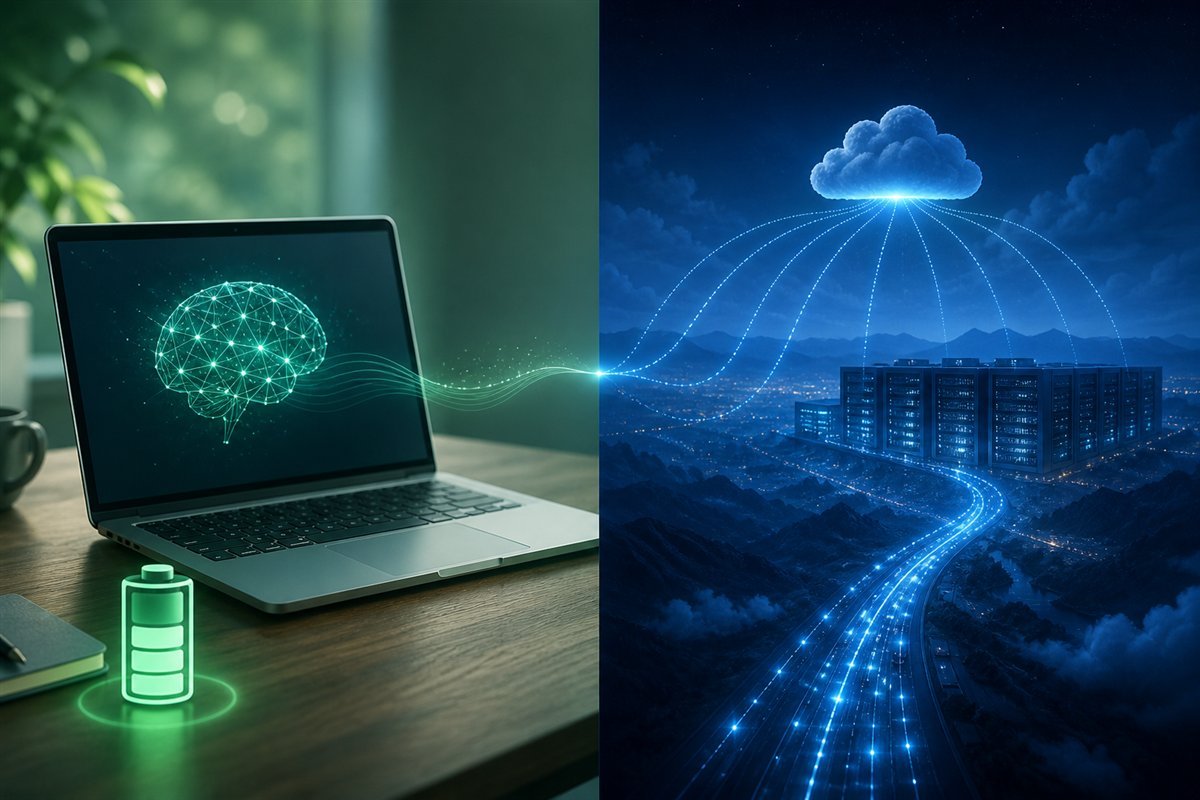
Processamento local pode reduzir latência, funcionar sem conexão e evitar que determinados dados sejam enviados a um servidor. Também permite respostas rápidas para efeitos contínuos. Isso não torna o recurso automaticamente privado: o aplicativo ainda pode coletar telemetria ou sincronizar resultados. A política do software continua relevante.
NPU economiza bateria?
Em tarefas compatíveis, sim: um bloco especializado pode entregar o resultado usando menos energia do que CPU ou GPU. O ganho depende da carga. Se o modelo não couber na memória disponível ou exigir operações não suportadas, partes do trabalho migram para outros componentes.
É preciso comprar um “AI PC”?
Para navegar, editar documentos e usar serviços de IA na nuvem, uma NPU não é requisito. Ela se torna interessante quando recursos locais fazem parte da rotina, quando autonomia é prioridade ou quando o software profissional adotado demonstra suporte concreto. Antes da compra, verifique aplicativos, memória RAM, bateria, desempenho geral e possibilidade de atualização — não apenas o número de TOPS.
Limitações atuais
O ecossistema ainda combina padrões e ferramentas diferentes. Um aplicativo pode aproveitar uma NPU em um sistema e recorrer à GPU em outro. Modelos grandes continuam exigindo muita memória e podem rodar melhor em hardware gráfico dedicado ou na nuvem. Há também funções comercializadas como IA que quase não dependem da NPU.
Como verificar se a NPU está sendo usada
Sistemas recentes podem exibir o uso do acelerador no gerenciador de tarefas ou em ferramentas do fabricante. O indicador mais confiável, porém, é a documentação do aplicativo. Procure suporte explícito ao processador e à versão instalada, além de medições de consumo e tempo na tarefa que importa.
Da rede neural ao silício
Um modelo de IA é composto por camadas de operações numéricas e parâmetros aprendidos. Antes de rodar na NPU, ele costuma ser convertido para um formato aceito pelo runtime do sistema. Nessa etapa, operações podem ser agrupadas, reorganizadas ou quantizadas para usar números com menos bits. O objetivo é reduzir memória e energia sem perda inaceitável de qualidade.
Quando uma operação não é suportada, o runtime pode executá-la na CPU ou GPU. Essa transferência tem custo: dados precisam mudar de memória ou sincronizar etapas. Por isso, uma NPU com muitos TOPS pode entregar resultado modesto se o modelo alternar constantemente entre processadores.
Quantização: por que a precisão numérica importa
Treinamento frequentemente usa números de maior precisão, enquanto inferência pode funcionar com formatos menores, como inteiros de 8 bits ou precisões ainda mais compactas. A quantização reduz tamanho e aumenta a quantidade de operações executadas, mas exige calibração. Modelos diferentes reagem de forma distinta, e métricas de qualidade precisam acompanhar o ganho de velocidade.
Quando fabricantes divulgam TOPS, o número normalmente está ligado a uma precisão específica. Comparar valores sem verificar o formato é como comparar motores medidos em condições diferentes. Aplicações reais também incluem preparação dos dados, memória e pós-processamento.
Memória compartilhada e tamanho dos modelos
Em muitos notebooks, CPU, GPU integrada e NPU acessam a mesma memória do sistema. Isso pode evitar cópias, porém todos disputam largura de banda e capacidade. Um modelo que ocupa vários gigabytes reduz a RAM disponível aos aplicativos. Para IA local, 16 GB pode ser o mínimo prático em alguns fluxos, enquanto projetos maiores se beneficiam de 32 GB ou mais; a necessidade depende do modelo, não do rótulo “AI PC”.
Memória não atualizável merece atenção. Comprar apenas pela NPU e escolher pouca RAM pode limitar a vida útil do equipamento mais do que uma diferença pequena de TOPS.
Privacidade local: benefícios e limites
Se áudio, imagem ou texto são processados integralmente no dispositivo, o conteúdo pode evitar trânsito até um servidor. Isso é valioso em transcrição de reuniões, acessibilidade e análise de documentos. Entretanto, processamento local não significa automaticamente que nada sai do computador. O aplicativo pode enviar telemetria, sincronizar arquivos ou recorrer à nuvem quando a tarefa excede a capacidade local.
Confira permissões, política de privacidade e indicadores de conexão. Em empresas, controles de rede e auditoria ajudam a verificar o comportamento em vez de depender apenas de declarações de marketing.
NPU em videoconferências
Efeitos de câmera são um caso adequado porque precisam rodar durante longos períodos com baixa latência. Desfoque, correção do olhar, enquadramento e supressão de ruído podem ser acelerados sem manter a GPU em alta potência. O benefício aparece como menor uso de CPU, ventoinha mais silenciosa e autonomia superior, não necessariamente como uma imagem dramaticamente melhor.
O resultado depende do aplicativo usar a API correta. Dois programas no mesmo notebook podem apresentar consumo diferente porque apenas um encaminha os modelos para a NPU.
NPU para modelos generativos
Modelos de linguagem compactos, geração de imagem leve e edição assistida podem usar aceleradores neurais. A NPU é particularmente útil para tarefas persistentes e eficientes; uma GPU dedicada ainda costuma dominar cargas grandes que exigem alta largura de banda. Sistemas podem dividir o fluxo: NPU para reconhecimento contínuo, GPU para geração pesada e CPU para coordenação.
Não existe garantia de que um modelo popular na internet rodará automaticamente. Ele precisa caber na memória, ter operadores compatíveis e ser disponibilizado em formato aceito. Ferramentas de desenvolvimento estão evoluindo para abstrair diferenças, mas a portabilidade ainda não é perfeita.
O papel do sistema operacional
O sistema oferece APIs para descobrir aceleradores, selecionar provedores de execução e controlar energia. Windows ML, DirectML, ONNX Runtime e estruturas dos fabricantes são exemplos do ecossistema, com suporte que muda por versão. Em outros sistemas, frameworks próprios desempenham função semelhante.
Atualizações de drivers e do runtime podem melhorar compatibilidade depois da compra. Ao mesmo tempo, depender de uma promessa futura é arriscado. Avalie recursos disponíveis na versão atual e trate anúncios sem data como possibilidade, não como especificação.
Como comparar dois computadores com NPU
- Liste os aplicativos e funções que você realmente usará.
- Confirme suporte documentado ao hardware de cada modelo.
- Compare desempenho e consumo na tarefa completa, não só TOPS.
- Verifique RAM, armazenamento, refrigeração e autonomia.
- Considere GPU quando criação, 3D ou modelos grandes forem prioridade.
- Analise qualidade de tela, teclado, portas e reparabilidade.
Um computador equilibrado com NPU menor pode ser melhor compra que um modelo cujo único destaque é a métrica de IA.
Desenvolvimento: quando vale direcionar um modelo à NPU
Para desenvolvedores, o primeiro passo é medir. Estabeleça latência, consumo e qualidade na CPU ou GPU; depois converta e teste na NPU. Observe operadores que caem para outro processador e o tempo gasto em transferência. Perfis de energia são tão importantes quanto testes de velocidade quando o objetivo é execução contínua.
Também é necessário planejar uma rota alternativa. Nem todo usuário terá NPU, e versões distintas suportam conjuntos diferentes. O aplicativo deve continuar funcional ou explicar claramente os requisitos.
Uma tecnologia em transição
NPUs já executam tarefas reais, mas a linguagem comercial frequentemente mistura hardware, serviços de nuvem e funções de software. A maturidade será percebida quando mais aplicativos usarem aceleradores por padrões comuns e quando testes independentes mostrarem ganhos consistentes. Até lá, compatibilidade verificável vale mais do que listas genéricas de “experiências de IA”.
Desempenho sustentado e temperatura
Uma demonstração curta não revela como o notebook se comporta depois de meia hora. NPUs tendem a ser eficientes, mas dividem limites térmicos com outros blocos do chip. Em cargas combinadas, o sistema pode ajustar frequências para controlar calor. Testes úteis medem latência, consumo e ruído durante o fluxo completo, com bateria e tomada.
Acessibilidade como aplicação concreta
Legendas em tempo real, descrição de imagens, rastreamento de atenção e limpeza de voz podem funcionar com menor atraso quando executados localmente. Isso permite recursos contínuos mesmo com conexão instável. Qualidade, idiomas suportados e possibilidade de revisão continuam importantes: um acelerador melhora execução, não elimina erros do modelo.
Segurança de modelos locais
Arquivos de modelos e runtimes também fazem parte da superfície de ataque. Baixe componentes de fontes confiáveis, mantenha drivers atualizados e controle quais aplicativos acessam câmera, microfone e documentos. Processar localmente reduz certos fluxos de dados, mas um software malicioso com acesso ao dispositivo continua sendo ameaça.
O que esperar nos próximos anos
A tendência é que o sistema escolha automaticamente entre CPU, GPU, NPU e nuvem conforme custo, privacidade e desempenho. Modelos menores devem assumir tarefas rotineiras, enquanto cargas grandes continuarão híbridas. Padrões de software mais maduros podem reduzir a dependência de um único fabricante.
Para o consumidor, isso reforça a importância de atualizações, memória suficiente e suporte prolongado. O valor da NPU será medido por aplicativos úteis e eficientes, não pela quantidade de recursos anunciados no lançamento.
Conclusão
A NPU é menos um “novo cérebro” e mais um coprocessador eficiente. Sua importância cresce à medida que recursos de voz, imagem e linguagem passam a rodar continuamente no dispositivo. Para o comprador, a pergunta útil não é se o computador tem IA, mas quais tarefas reais são aceleradas, com qual software e a que custo de energia.