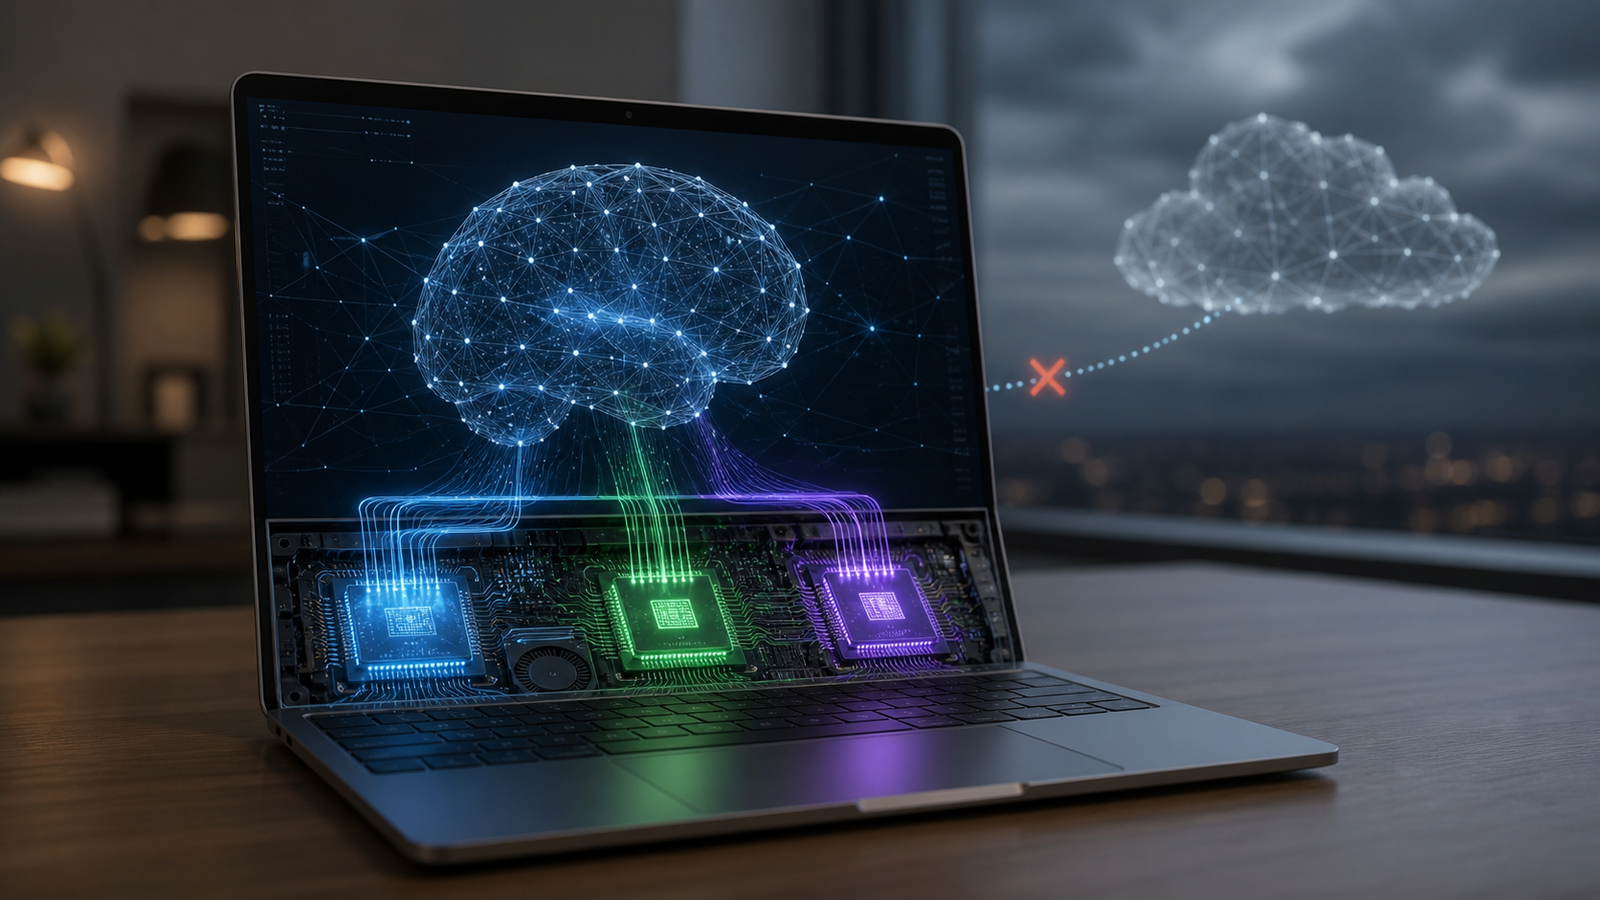
IA local executa modelos diretamente no computador ou celular, sem enviar cada solicitação a um serviço remoto. Isso pode melhorar privacidade, latência e funcionamento offline, mas exige memória, capacidade de processamento e escolhas conscientes sobre tamanho e qualidade do modelo.
O que significa executar IA no dispositivo?
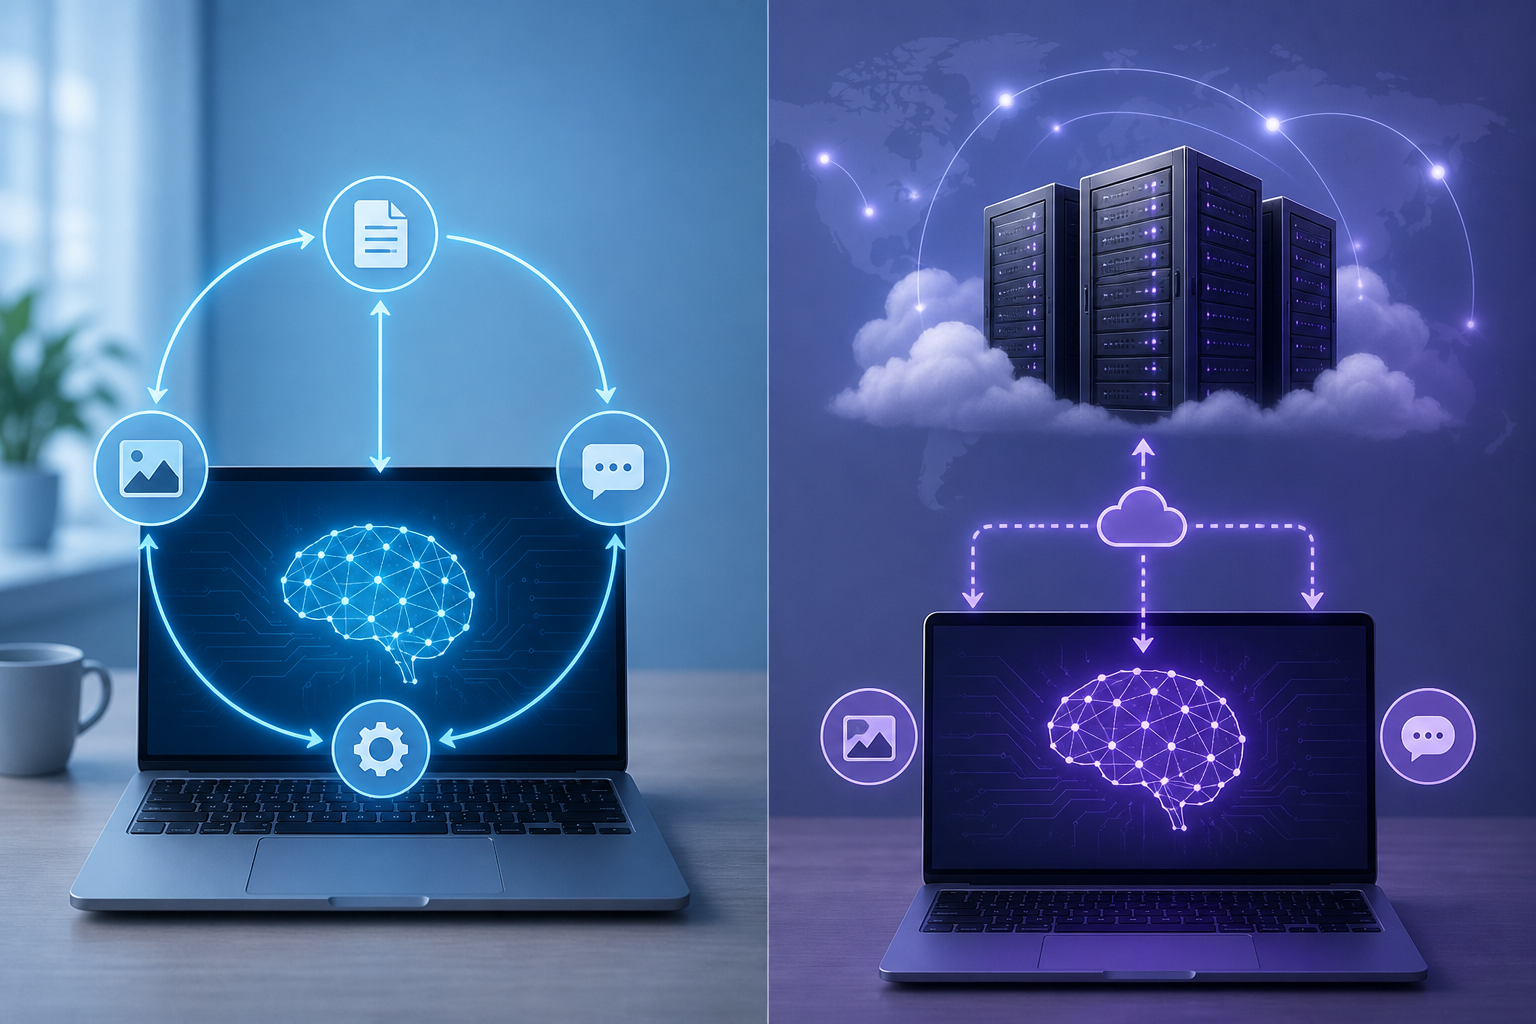
O modelo, ou parte dele, fica armazenado e é processado pelo hardware local. CPU, GPU e NPU podem dividir tarefas. Alguns aplicativos são totalmente locais; outros usam arquitetura híbrida, resolvendo tarefas simples no aparelho e recorrendo à nuvem para trabalhos maiores.
Privacidade: vantagem real, não automática
Manter dados no dispositivo reduz transmissões, mas o aplicativo ainda pode coletar telemetria, sincronizar histórico ou carregar arquivos. É preciso conferir política, permissões e atividade de rede. Um modelo baixado também pode ter riscos de origem e formato.
Latência e disponibilidade
Sem ida ao servidor, respostas curtas podem começar rapidamente e continuar funcionando offline. O desempenho é previsível porque não depende da fila de um serviço, embora varie conforme temperatura, bateria, memória e outros programas.
Por que modelos menores?
Modelos de linguagem pequenos reduzem memória e cálculo. Técnicas como quantização armazenam pesos com menor precisão para economizar recursos. O ganho pode vir acompanhado de perda de qualidade, especialmente em raciocínio complexo, idiomas menos representados ou tarefas fora do treinamento.
CPU, GPU e NPU
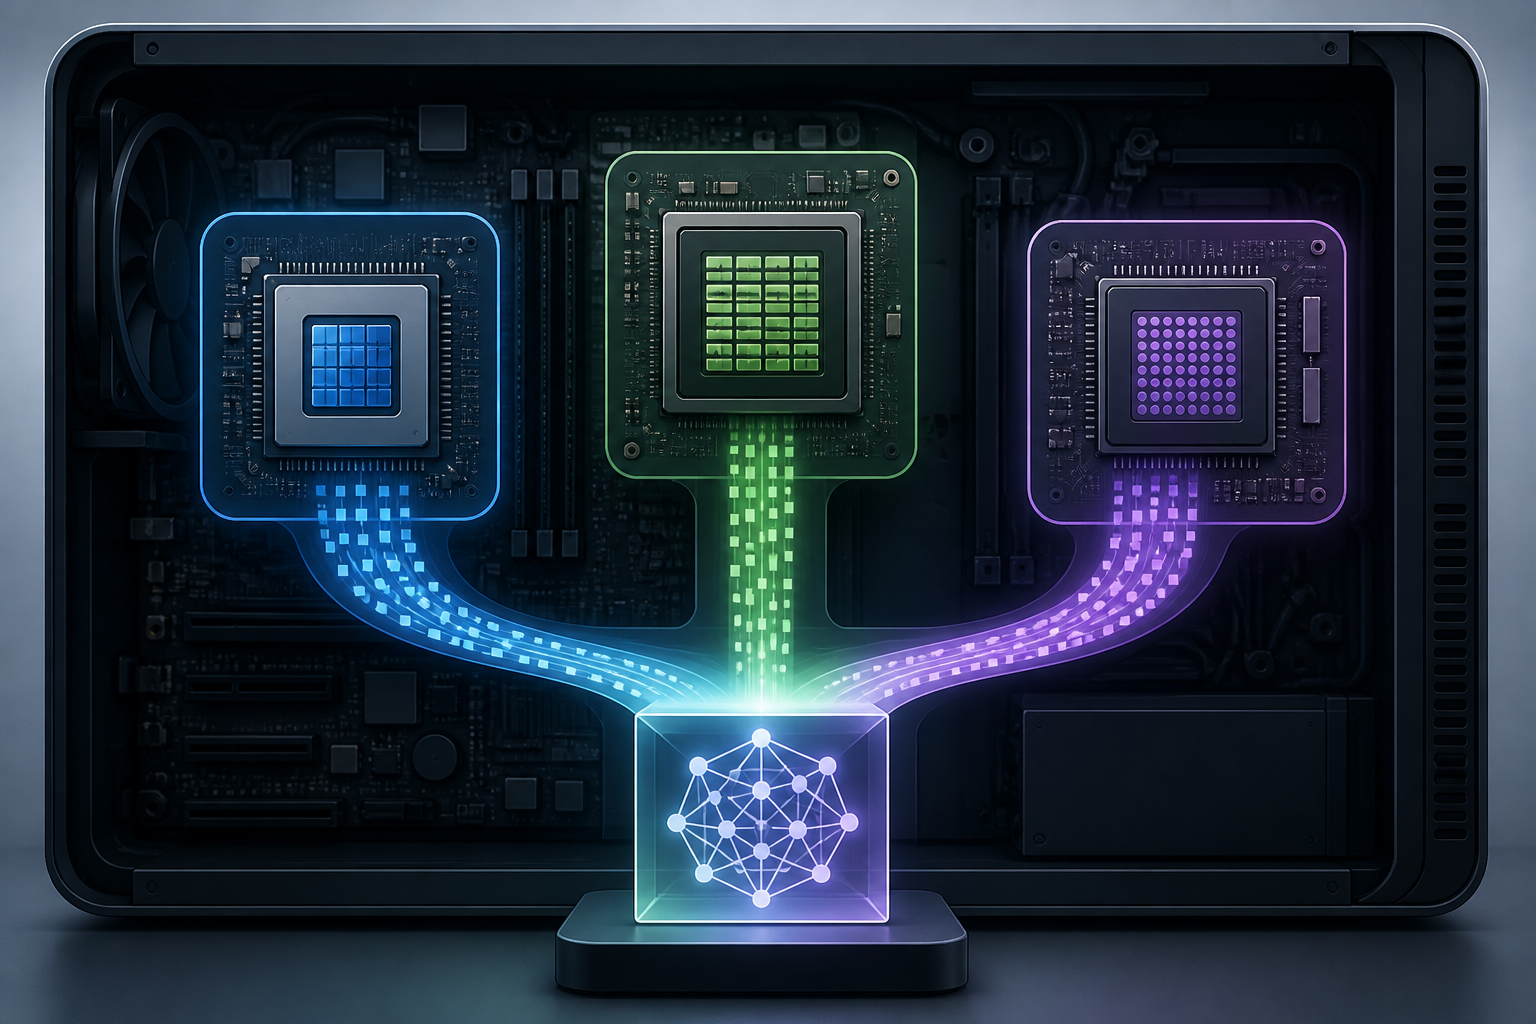
CPU é flexível, mas pode consumir mais energia. GPU oferece paralelismo e costuma ser eficiente para modelos maiores. NPU foi desenhada para cargas de IA com boa eficiência energética. O software precisa aproveitar o componente disponível; ter uma NPU não garante que todo aplicativo a utilizará.
Memória é um limite decisivo
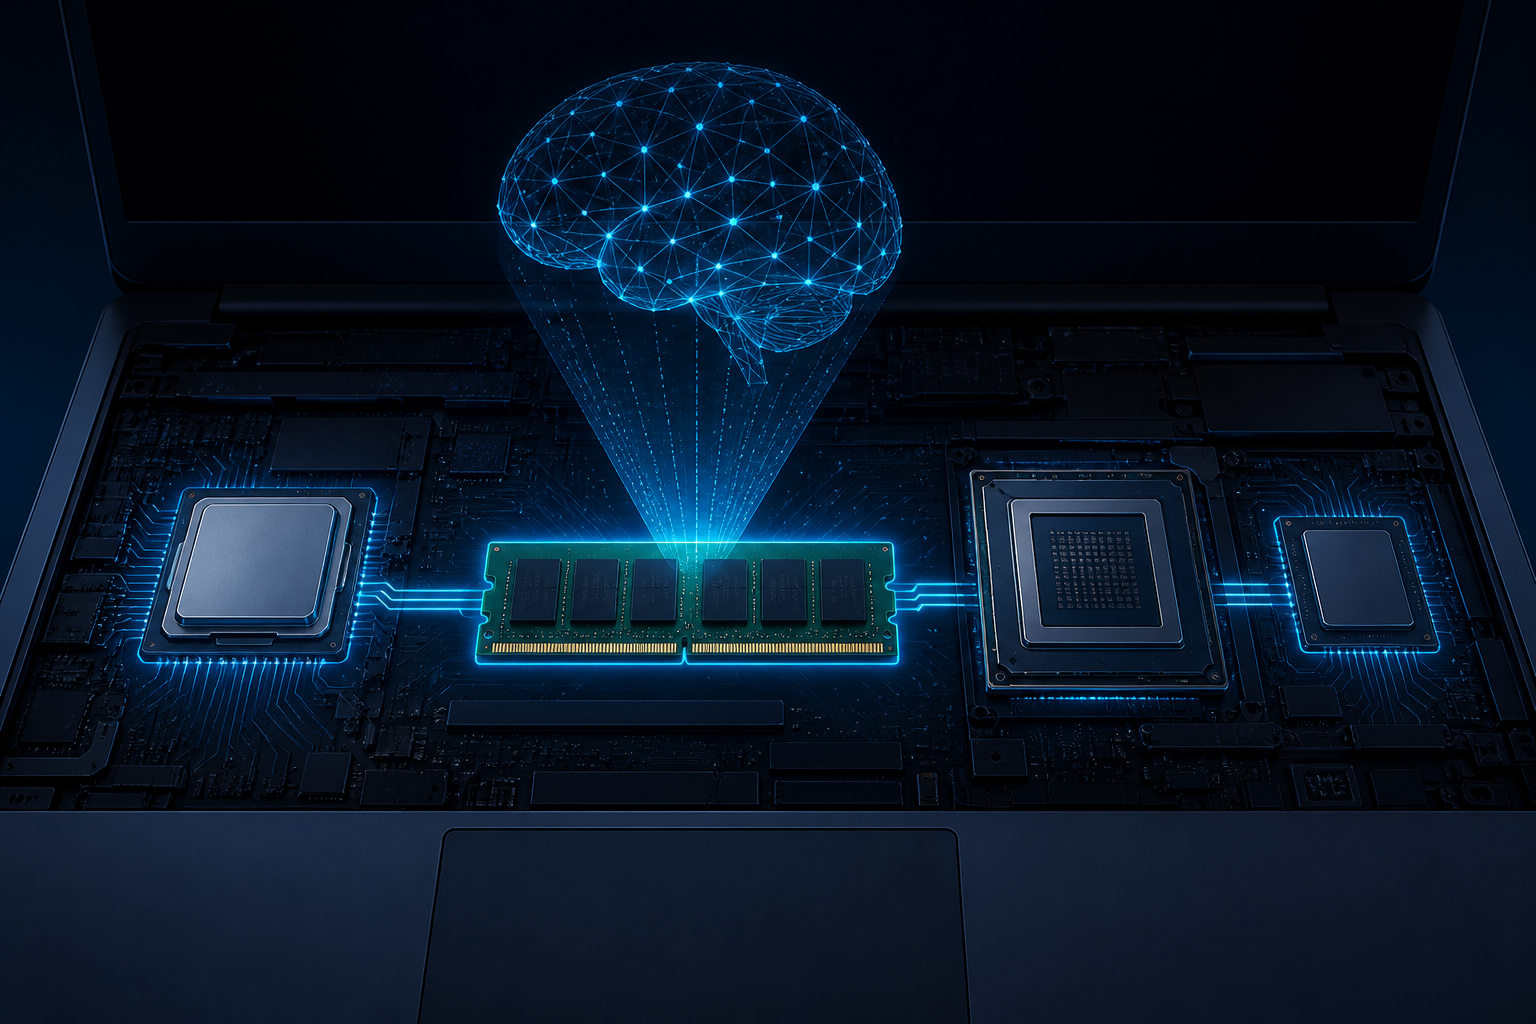
Além dos pesos, o sistema mantém contexto e estruturas temporárias. Quanto maior a janela de contexto e o modelo, maior a pressão sobre RAM ou memória de vídeo. Quando dados são deslocados lentamente entre memória e processador, a experiência degrada.
Usos adequados
- Resumo e reescrita de textos privados.
- Transcrição e tradução offline.
- Busca semântica em documentos locais.
- Classificação de imagens e automações pessoais.
- Assistência em ambientes com conexão instável.
Limitações e segurança
Modelos locais também alucinam, reproduzem vieses e podem seguir instruções maliciosas presentes em documentos. Isolamento, permissões mínimas e confirmação antes de executar ações continuam necessários. Modelos baixados devem vir de fontes verificáveis.
Como escolher
- Defina tarefa e nível de privacidade.
- Verifique RAM, GPU/NPU e espaço disponível.
- Prefira formatos e ferramentas mantidos.
- Compare qualidade no português e em seus próprios documentos.
- Observe consumo, temperatura e licença de uso.
Local ou nuvem?
Nuvem oferece modelos maiores e atualização centralizada; local oferece controle e disponibilidade. A melhor arquitetura pode ser híbrida, com decisão explícita sobre quais dados podem sair do dispositivo. O usuário deve saber quando ocorre a mudança.
Local não significa automaticamente privado ou offline
O modelo pode executar no aparelho e, ainda assim, o aplicativo enviar telemetria, verificar licença, sincronizar conversas ou consultar serviços externos. A privacidade depende do fluxo completo de dados, não apenas do lugar em que ocorre a inferência. Verifique permissões, política de dados, opções de sincronização e comportamento sem conexão. Se a tarefa envolve conteúdo sensível, um teste de rede controlado pode ajudar a confirmar a promessa do fornecedor.
A primeira instalação normalmente exige internet para baixar modelo, runtime e atualizações. Alguns programas também atualizam catálogos ou procuram versões mais adequadas ao hardware. Isso é diferente de enviar prompts e respostas, mas precisa ser explicado. Uma solução responsável informa quais conexões são necessárias, permite administrar atualizações e deixa claro quando existe fallback para a nuvem.
Como estimar memória e espaço necessários
O número de parâmetros é apenas o começo. Cada peso ocupa espaço conforme a precisão usada; a quantização reduz esse consumo ao representar pesos com menos bits. Além do arquivo do modelo, a execução precisa de memória para contexto, cache de atenção, buffers e runtime. A janela de contexto maior aumenta o uso, mesmo quando o modelo permanece igual.
Não conte toda a RAM instalada como disponível. Sistema operacional, navegador e outros programas competem pelo mesmo recurso. Em GPU dedicada, a memória de vídeo pode limitar o modelo antes da capacidade de cálculo. Em equipamentos com memória compartilhada, CPU e aceleradores disputam a mesma reserva. Mantenha margem para evitar troca excessiva com o armazenamento, travamentos ou queda brusca de velocidade.
CPU, GPU e NPU cumprem papéis diferentes
A CPU é o caminho mais compatível e pode ser suficiente para modelos pequenos, classificação e experimentos. A GPU costuma oferecer maior vazão em cargas paralelas e modelos generativos maiores, mas pode consumir mais energia. A NPU busca eficiência em inferência contínua e recursos integrados ao sistema, especialmente em notebooks, embora dependa de modelos, formatos e operadores compatíveis.
Uma especificação em TOPS não prevê sozinha a experiência. Precisão numérica, largura de banda de memória, drivers e suporte do runtime influenciam o resultado. O mesmo equipamento pode executar parte do modelo na NPU e transferir operações não compatíveis à CPU ou GPU. Compare o aplicativo e o modelo reais, pois ter acelerador não garante que o software o utilize.
Métricas úteis além de “funcionou”
Para texto, observe tempo até o primeiro token, velocidade de geração e estabilidade em conversas longas. Para imagem, transcrição ou classificação, meça latência total e uso sustentado. Registre consumo de memória, temperatura, ruído das ventoinhas e impacto na bateria. Um teste curto pode parecer rápido, mas o desempenho cair quando o equipamento aquece.
Qualidade também precisa de avaliação. Crie um conjunto de tarefas representativas em português, com exemplos fáceis, difíceis e situações em que a resposta correta é admitir incerteza. Compare versões usando o mesmo conteúdo e critérios. Um modelo mais rápido ou menor não é melhor se omite informações essenciais, inventa referências ou falha nas instruções importantes do seu fluxo.
Busca em documentos locais e RAG
Uma aplicação pode dividir documentos em trechos, produzir representações vetoriais e recuperar passagens relevantes antes de pedir uma resposta ao modelo. Essa técnica, conhecida como geração aumentada por recuperação, ajuda a trabalhar com arquivos que não estavam no treinamento. Ela não garante correção: extração ruim, tabelas complexas, imagens e trechos fora de contexto podem produzir respostas enganosas.
Mostre as passagens usadas e mantenha um caminho para abrir o documento original. Defina quais pastas entram no índice, quem pode consultá-las e como arquivos apagados são removidos. Se diferentes pessoas compartilham o computador, o índice local também precisa respeitar permissões. Uma base vetorial pode revelar conteúdo mesmo quando o documento original está protegido por outro aplicativo.
Documentos podem conter instruções maliciosas
Um texto importado pode tentar convencer o modelo ou agente a ignorar regras, revelar outros arquivos ou executar ações. Esse risco de injeção de prompt existe mesmo sem nuvem. Trate documentos como dados não confiáveis, separe conteúdo de instruções do sistema e exija confirmação humana antes de enviar mensagens, apagar arquivos, instalar programas ou alterar configurações.
Ferramentas locais devem operar com permissões mínimas. Um assistente que resume arquivos não precisa necessariamente acessar contatos, navegador inteiro ou pastas do sistema. Prefira execução isolada, limite diretórios autorizados e mantenha registro das ações. O fato de o modelo estar no seu computador não transforma todas as decisões geradas por ele em seguras.
Origem, licença e integridade do modelo
Baixe modelos e runtimes de repositórios reconhecidos, confira o responsável pela publicação e leia o cartão do modelo. Licenças podem restringir redistribuição, uso comercial ou determinados cenários. Arquivos grandes também podem ser substituídos ou empacotados com software indesejado; formatos que executam código exigem cuidado adicional.
Registre nome, versão, origem, hash quando fornecido e licença aplicável. Atualizações podem corrigir falhas ou alterar qualidade e comportamento. Em uso profissional, teste uma nova versão antes de substituir a anterior e mantenha um caminho de reversão. A governança de modelos locais se parece com a gestão de outras dependências de software.
Quando escolher arquitetura híbrida
Uma estratégia híbrida pode manter classificação, busca e rascunhos no aparelho, recorrendo a um modelo remoto apenas para tarefas que exigem mais capacidade. A decisão precisa ser visível e baseada em regras. Conteúdo confidencial não deve migrar silenciosamente para a nuvem porque o modelo local ficou lento ou atingiu um limite.
Defina categorias de dados, remova informações desnecessárias e peça consentimento quando houver mudança de ambiente. Mostre ao usuário onde a tarefa será processada e permita cancelar. Também documente retenção, treinamento e localização do serviço remoto. Arquitetura híbrida é útil quando oferece escolha controlada, não quando esconde dependências.
Roteiro de teste antes de adotar
- Escolha três a cinco tarefas reais e prepare exemplos sem dados sensíveis.
- Confirme modelo, licença, tamanho, runtime e requisitos de hardware.
- Meça qualidade, latência, memória, temperatura e consumo de bateria.
- Teste sem internet e observe quais recursos deixam de funcionar.
- Revise permissões, telemetria, sincronização e possibilidade de fallback remoto.
- Experimente documentos adversariais e respostas incorretas antes de liberar ações.
- Documente atualização, remoção do modelo e exclusão de históricos e índices.
A aprovação deve considerar benefício concreto e risco residual. Para uma tarefa simples, um modelo pequeno pode entregar melhor experiência e menor custo. Para raciocínio complexo, conhecimento atualizado ou alto volume, a nuvem talvez continue mais adequada. O objetivo é selecionar a arquitetura que atende à tarefa com transparência, não transformar execução local em requisito absoluto.
Conclusão
IA local não é apenas uma versão menor da nuvem. Ela muda privacidade, custo, latência e operação. O resultado depende de encaixar modelo, tarefa e hardware — e de verificar se o aplicativo realmente mantém os dados onde promete.
Fontes e referências
- Microsoft Learn — modelos locais prontos para uso
- Microsoft — cartão de plataforma Phi Silica
- Microsoft Learn — Windows AI e execução no dispositivo
- Hugging Face — uso de modelos localmente
- NIST — AI Risk Management Framework